在 Bulin 47 AI 里保留完整造型
Bulin 47 AI 模板用照片 1 定义整个人物。请选择一张能看清脸、头发、衣服和上半身的照片。原表演者的墨镜、浅粉色衬衫和其他细节,只有你的照片里也有时才会保留。裁得太紧、看不清服装时,模型能跟随的信息就更少。
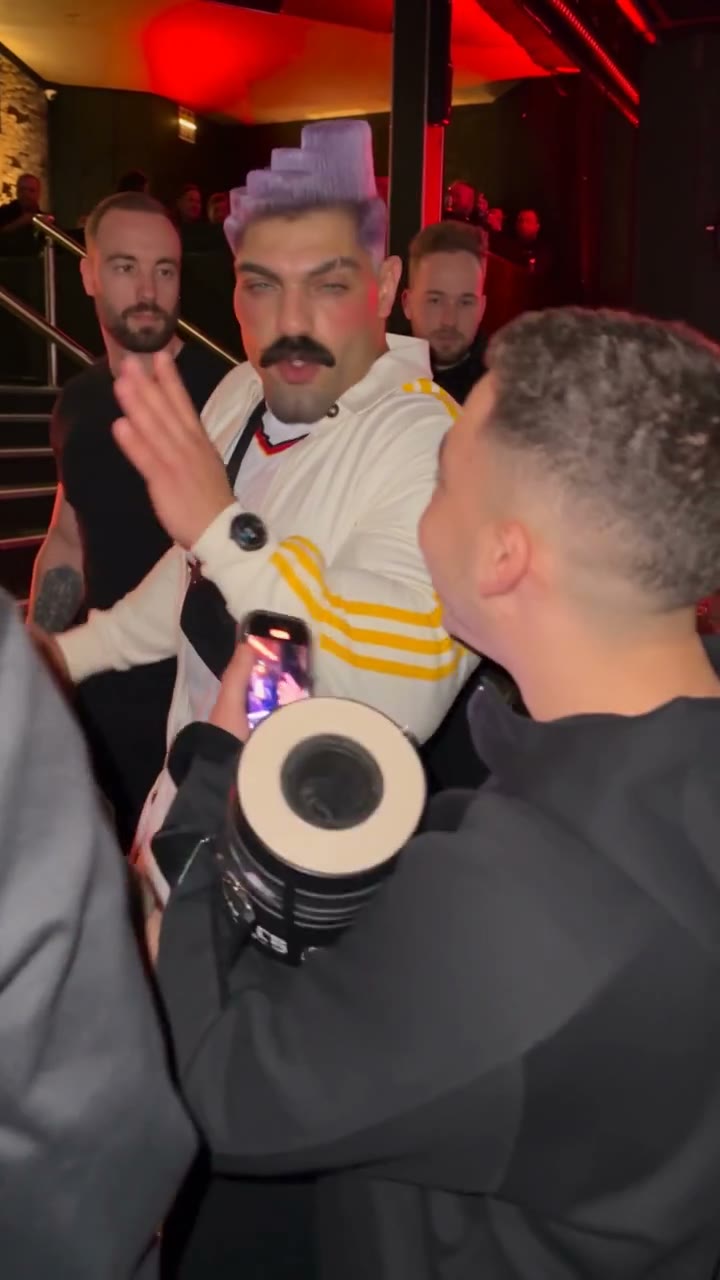
用一张人物照片和原声制作 Bulin 47 AI 视频。模板替换主角,并尽量保留拿着便携音箱的人、人群和镜头运动。
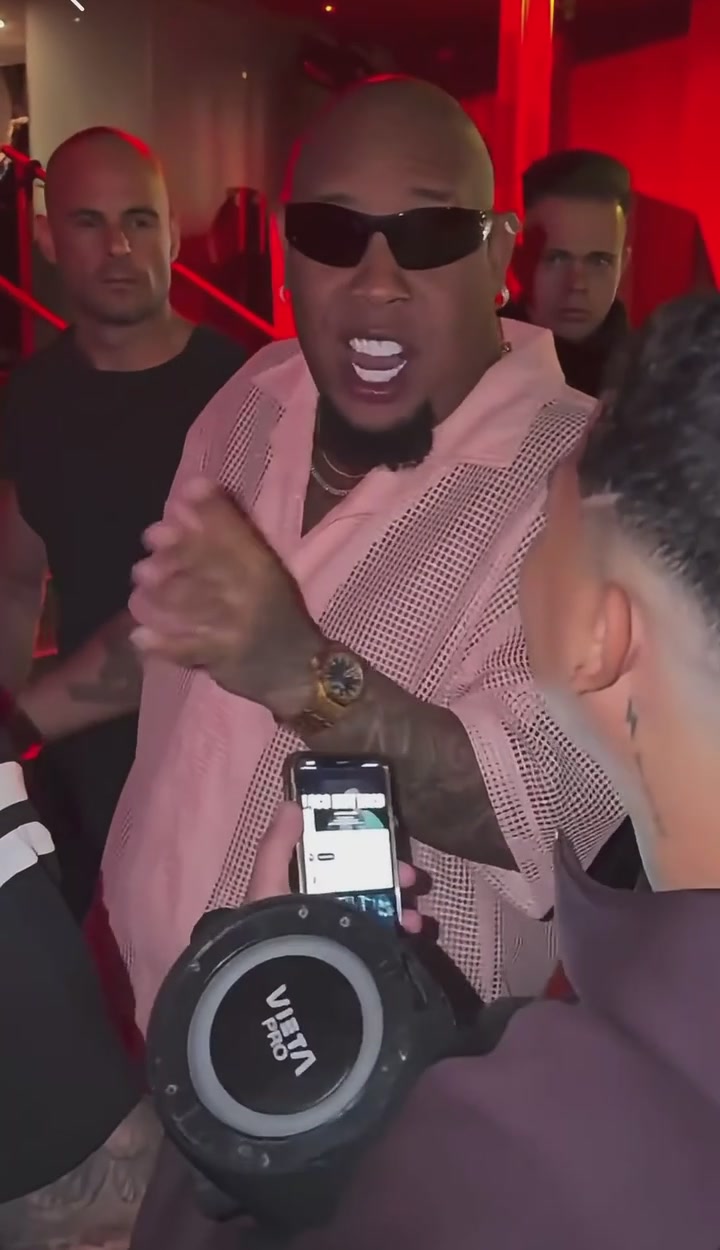
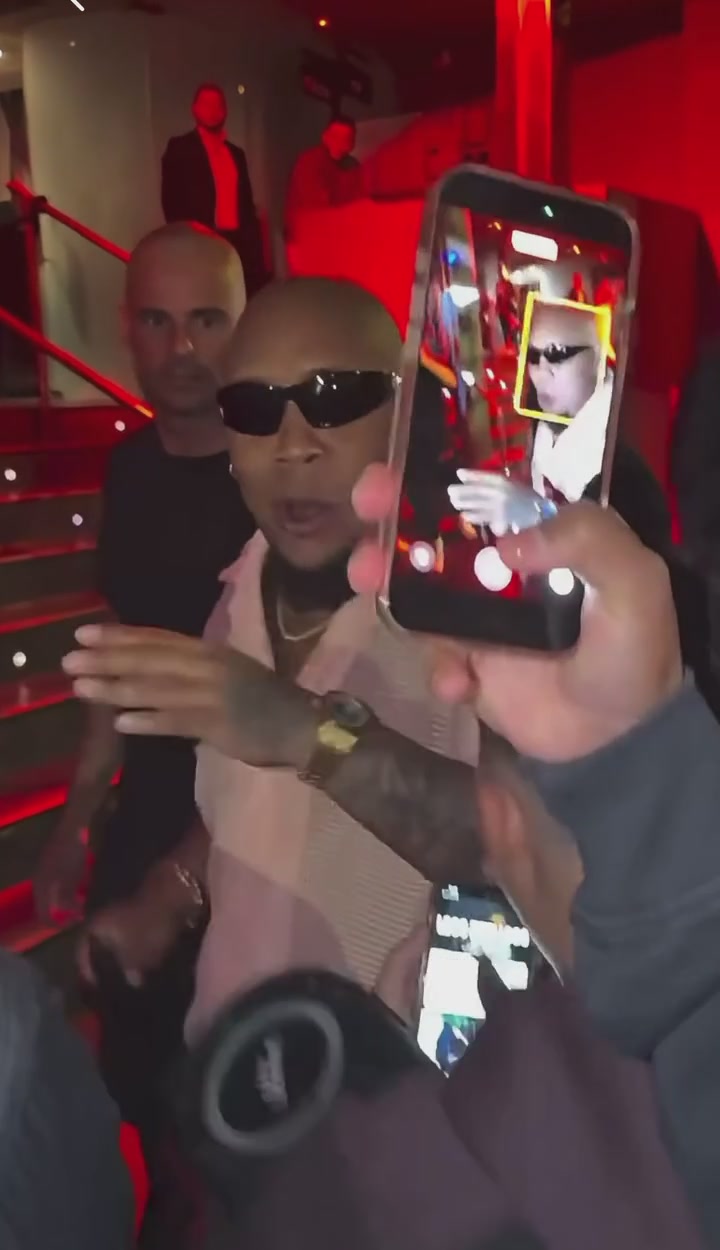
Bulin 47 AI 把一张人物照片做成一段说唱表演视频。替换目标是戴墨镜、敞穿浅粉色衬衫、站在拿便携音箱的人后面的那位表演者。已载入的片段提供舞蹈、手势、镜头、房间和时间节奏。你的照片决定替换后的脸、头发、肤色、身体、衣服和配饰。周围的人不在替换角色里。
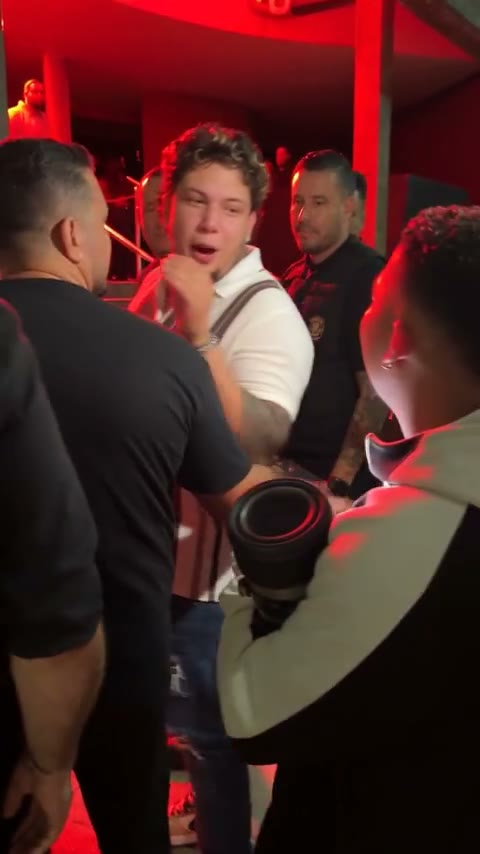
表演已经载入。先准备一张应成为主角的人物照片。
步骤 1
添加一张能看清脸、头发、衣服和上半身的照片。这是唯一的外观参考。拿便携音箱的人不需要照片。
步骤 2
登录并选择生成。上传照片不会开始付费请求。
步骤 3
打开我的作品,连同原声观看 Bulin 47 AI 结果,再下载你想保留的版本。
先看已载入表演里的角色和镜头。每条 Bulin 47 AI 视频都用你的照片替换一个人物,并尽量保留周围场景。
Bulin 47 AI 模板用照片 1 定义整个人物。请选择一张能看清脸、头发、衣服和上半身的照片。原表演者的墨镜、浅粉色衬衫和其他细节,只有你的照片里也有时才会保留。裁得太紧、看不清服装时,模型能跟随的信息就更少。
前景里拿着便携音箱的人不在替换角色里。Bulin 47 AI 要求编辑保留这个人的脸、衣服、动作和音箱,也保留房间里的其他人。你不需要第二张人群照片。人物重叠时仍可能被误改,所以既要看前景这个人,也要看你的主角。
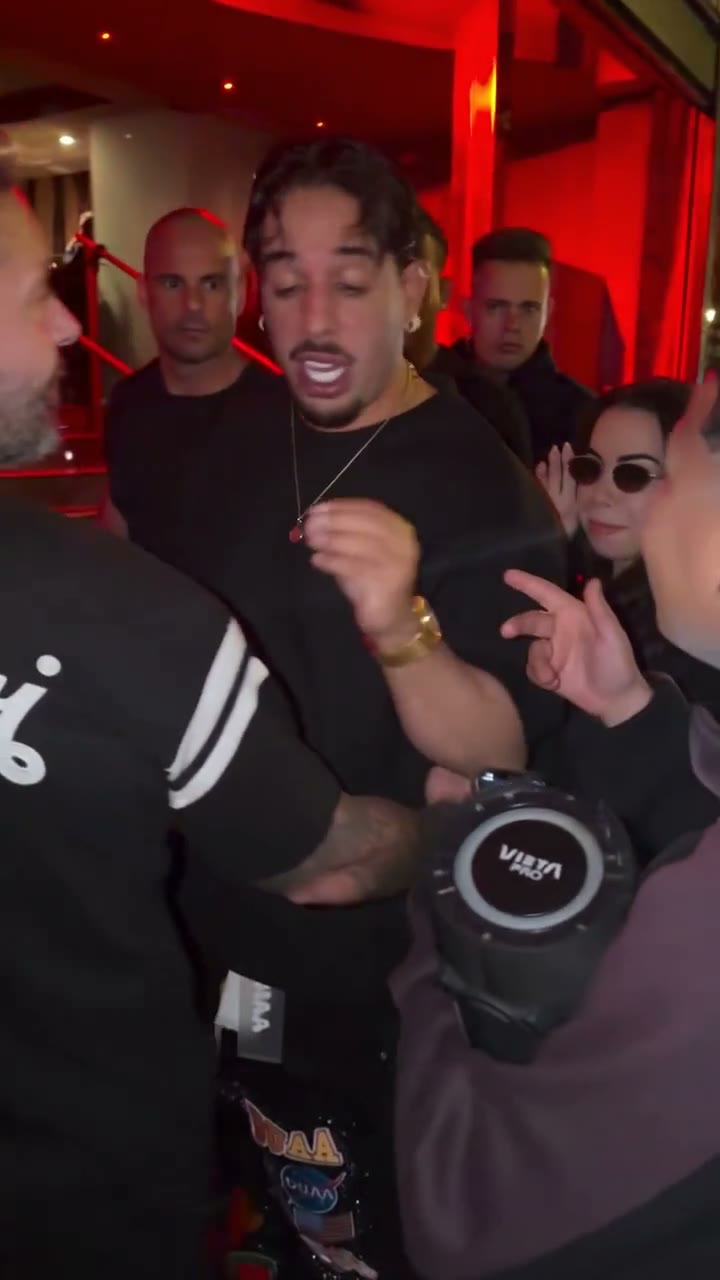
Bulin 47 AI 跟随的片段里有转身、近距离手势,结尾还有一部手机从镜头前经过。编辑会被要求在这些遮挡后面继续跟踪同一个人。预览时请看这个结尾:人物回来后应仍是同一张脸和同一套衣服。手、身份和嘴部动作仍可能走样;不保证精确对口型。
当你想把一个人物放进这段已载入的表演时,选择这个预设。如果要换房间、换一支舞,或替换好几个角色,请改用支持该任务的工具。
用 Bulin 47 AI 把你自己或一位同意出演的朋友放进这段表演。你可以从一张照片开始,不必自己录编舞。片段提供手势和节奏,不会录一段新的人声。
Bulin 47 AI 可以使用你有权编辑的人物图片。上传前先在图片里选定想要的服装。换一套衣服再试,是另一次生成;这一页不会一次点击就批量做出多套变装。
如果要用你自己的素材、另一组人群,或替换不止一个人,请到首页使用 Motion Transfer,并为那份素材写提示词。
一张照片即可开始编辑。下面这些设置说明生成前你可以做的选择。
生成前可以用替换更换已选图片。这里只有一个角色要填,不需要排列背景肖像或额外演员图片。
Bulin 47 AI 参考已经载入。选照片前先播放,看看你的人物将跟随的手势、转身和特写取景。
在我的作品或视频历史里找到 Bulin 47 AI 片段。你可以回到已有结果预览和下载,而不必再开始一次生成。
Bulin 47 AI 使用 Seedance 2.5 Edit,并带上这段参考的原声。不需要另传音轨。模型已为这个模板选好。
价格使用已载入的表演和你选择的分辨率。生成按钮会显示这次请求的积分。其他位置的套餐示例可能使用别的模型。
从你的第一个创意开始。
US$100.0 每年一次性收取
每年 2,400 积分
最多 400 张图片
最多生成 240 个视频
适合持续创作。
US$360.0 每年一次性收取
每年 21,600 积分
最多 3,600 张图片
最多生成 2,160 个视频
适合更高频、更多样的创作。
US$599.0 每年一次性收取
每年 48,000 积分
最多 8,000 张图片
最多生成 4,800 个视频
订阅前先体验
价格以美元计,税费及总额在结账时显示。订阅自动续费,可在账单设置中取消。订阅积分每期到期,一次性购买积分永不过期。
照片、谁会被替换、声音,以及完成的视频。
把一张照片上传到照片 1。不要用拼图,也不要上传有好几个人的图片。模型需要一个清楚的身份,因为只有一个角色会被替换。
只替换戴墨镜、敞穿浅粉色衬衫、站在拿便携音箱的人后面的那位主角。拿音箱的人、音箱本身,以及其他人都会被要求保留。
使用脸、头发、衣服和上半身都清楚的锐利照片。避免遮住脸、严重模糊,以及把你想看到的服装裁掉。
准备好的指令要求模型保留其他所有人,不添加、不删除、不复制、也不把人合并到一起。拥挤画面和重叠的身体仍可能混到一张脸或一只手,分享前请看这些时刻。
同一位表演者应在转身时继续出现,也应在手机或其他人挡住视线时继续出现。这是所要求的编辑,不是保证。手和身份细节仍可能出错。
编辑跟随源片表演者的嘴部动作和时间。不保证精确对口型,尤其是脸转开或被部分挡住时。
包含。完成的视频保留这段参考的原声。你不需要上传歌曲,也不需要打开音频开关。这一页不给音频命名,也不授予使用许可。
结果跟随已载入的表演,竖屏大约 23 秒。这一页没有时长选择器。
Seedance 2.5 Edit。模型已为这个模板选好。若要换模型或使用你自己的参考视频,请打开 Motion Transfer 首页,在那里选择合适的流程。
不需要。除非你有明确要改的地方,否则保留准备好的提示词。如果你编辑它,请让照片 1 继续对应这一位表演者,并且不要要求模型改其他的人。
你可以先看参考并选择照片,再决定是否生成。制作视频需要登录,以及不少于生成按钮所示的积分。选择照片不会开始付费请求。
生成后打开我的作品或视频历史,下载你想保留的结果。
请使用你有权编辑的照片。这个模板不授予素材或音轨的权利。只在你有许可的地方分享结果,并遵守目标平台对 AI 制作内容的规则。